
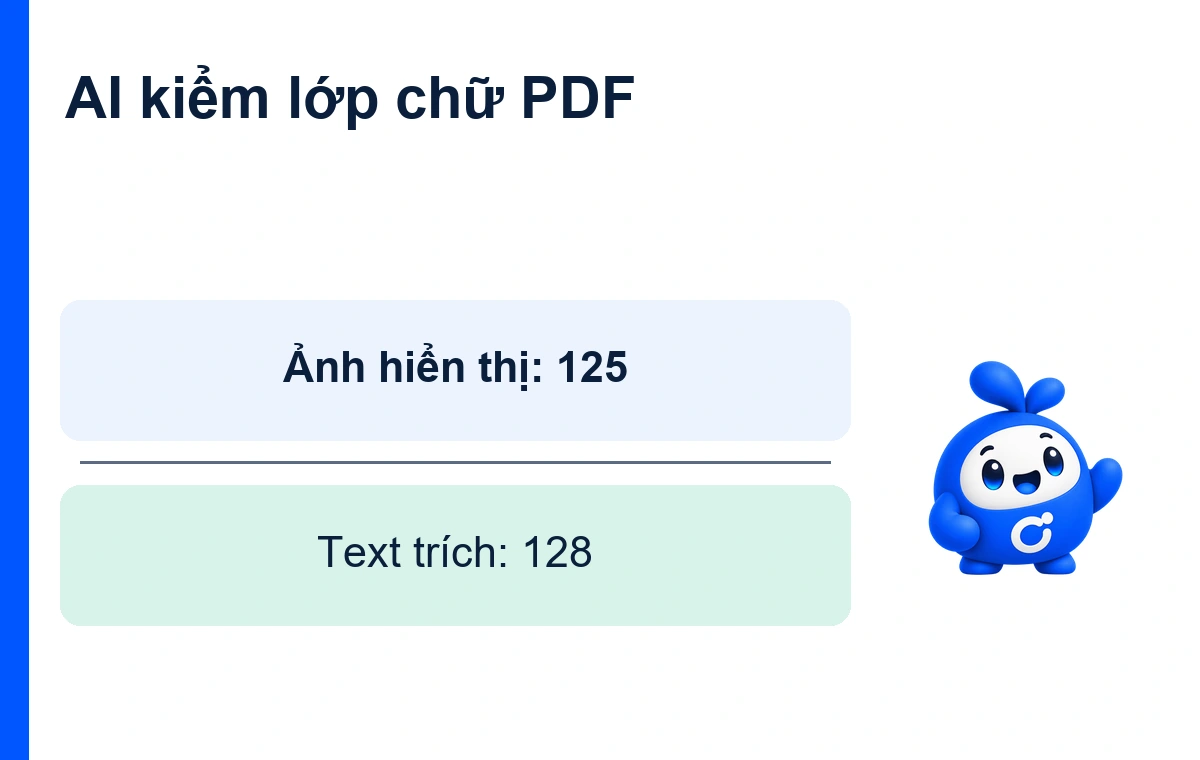
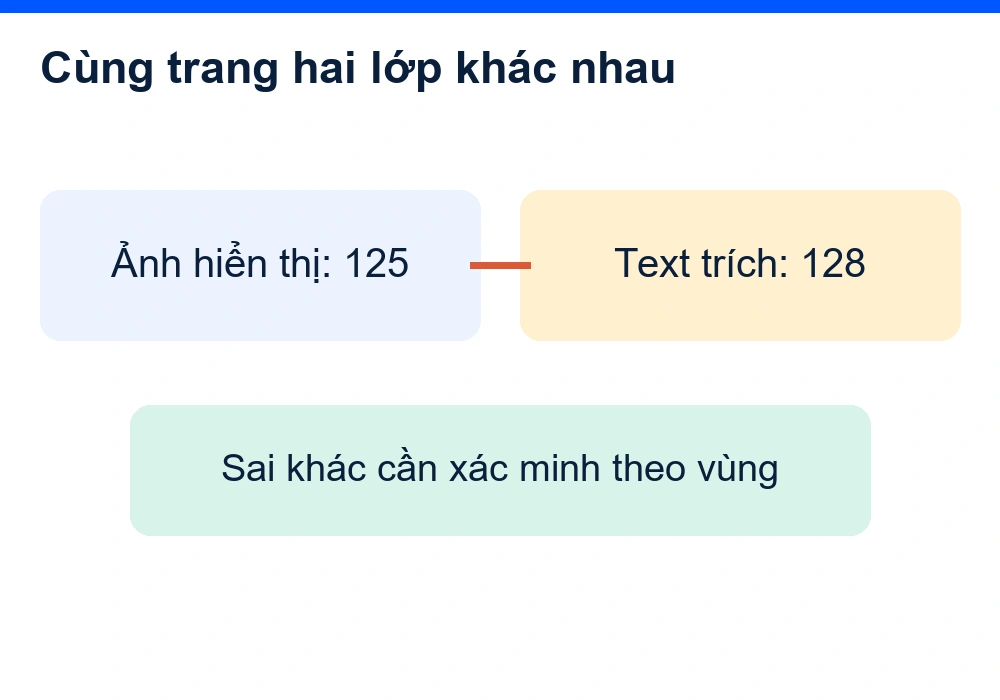
PDF nhìn rõ không có nghĩa lớp chữ dùng cho tìm kiếm và AI cũng đúng. Một trang scan có thể hiển thị số 125 nhưng văn bản trích ra thành 128; một trang khác có lớp chữ cũ nằm dưới ảnh đã thay. AI kiểm lớp chữ PDF cần so hai lớp theo vùng trước khi dùng nội dung để tạo bản ghi hoặc câu trả lời.
Ba loại đầu vào có thể giống nhau trên màn hình
PDF có chữ thật, PDF ảnh kèm chữ OCR và PDF ảnh không có chữ đều có thể mở và nhìn rõ. Thử chọn chữ chỉ cho biết có phần chữ có thể chọn; nó chưa chứng minh chữ đó khớp ảnh. Một trang hỗn hợp còn có chữ thật ở tiêu đề nhưng phần bảng chỉ là ảnh.
| Quan sát | Điều chưa được chứng minh | Phép kiểm tiếp |
|---|---|---|
| Chọn được chữ | Khớp nội dung nhìn thấy | Trích và so theo vùng |
| Không chọn được chữ | Trang không có nội dung | Mở ảnh và đọc mẫu |
| Tìm được một từ | Toàn trang đọc đúng | Thử số và thứ tự khối |
Bảng là khung chẩn đoán của Onter, không phải kết quả đánh giá một công cụ cụ thể. Đừng tự OCR lại toàn bộ file chỉ vì một trang thiếu chữ; trước hết cần biết trang nào gặp lỗi và đầu ra cần dùng ở mức nào.
Đặt ảnh vùng bên cạnh văn bản cùng vùng
Chọn một tiêu đề, một dòng số quan trọng và một khối hai cột. Ghi trang và tọa độ, trích chữ rồi đặt cạnh nội dung hiển thị. Đánh dấu thiếu, thay ký tự, lặp hoặc sai thứ tự. Mỗi lỗi cần ví dụ nhìn được; nhãn “PDF lỗi” chung chung không chỉ ra bước sửa.
Với số, so cả dấu âm, dấu thập phân và đơn vị. Với đoạn, kiểm phủ định và điều kiện. Với bảng, kiểm chủ thể đi cùng giá trị. Nếu chữ đúng nhưng thứ tự sai, đó là lỗi bố cục chứ không chỉ lỗi nhận ký tự; quan hệ ô và tiêu đề nhiều tầng cần được giữ khi tạo dữ liệu.
Tệp chữ phụ không luôn chứa toàn bộ chữ trong PDF
OCRmyPDF giải thích sidecar chỉ chứa phần chữ được OCR, có thể không có chữ vốn đã tồn tại hoặc trang bị bỏ qua. Vì vậy file TXT phụ rỗng không đủ để kết luận PDF không có chữ. Khi cần đánh giá toàn bộ văn bản, phải dùng cách trích phù hợp và kiểm phạm vi thực sự đã xử lý.
Ghi công cụ, cấu hình trang, ngôn ngữ và lỗi bỏ qua trong sổ kiểm tra. Đây là dấu vết để phân biệt “không có chữ” với “chưa xử lý”. Không cần công bố chi tiết kỹ thuật cho người đọc cuối, nhưng đội vận hành phải giữ chúng để giải thích vì sao đầu ra thiếu.
Chọn cách xử lý theo lỗi đã thấy
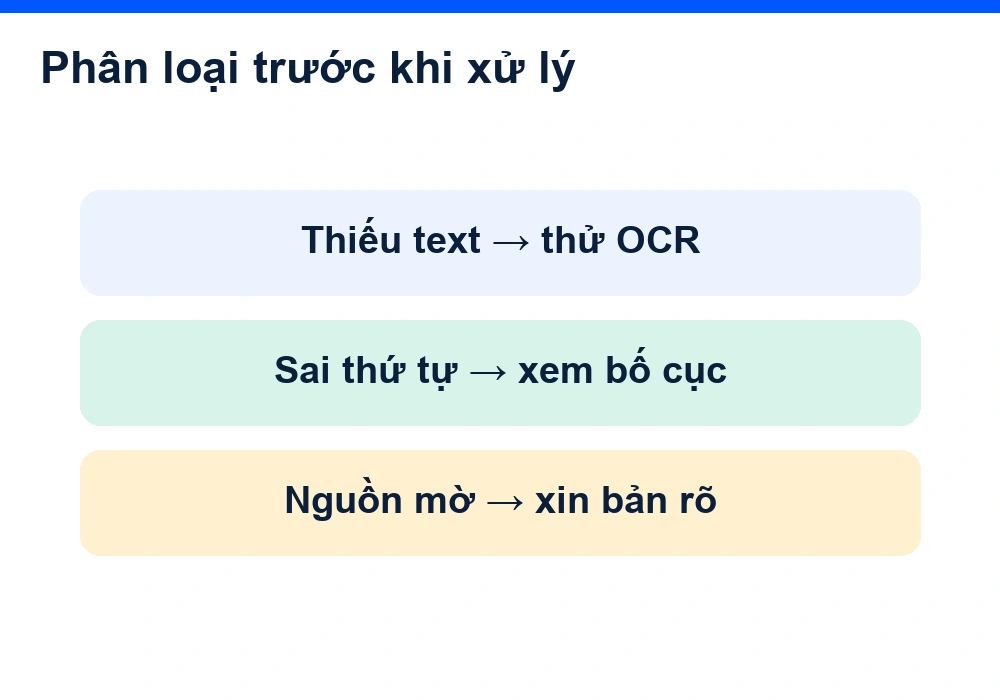
Nếu trang chỉ thiếu text, OCR một bản sao có thể là bước thử. Nếu text sai so với ảnh, thử tạo lại lớp OCR trên bản sao và so vùng đã lỗi. Nếu thứ tự đọc sai, cần phân tích bố cục. Nếu bản gốc rõ nhưng chữ trích bị lỗi phông hoặc mã hóa, ưu tiên tìm bản xuất đúng từ nguồn.
Không sửa tệp lưu gốc đã ký hoặc dùng làm bằng chứng tiếp nhận. Giữ bản dẫn xuất riêng với tên và trạng thái rõ. OCRmyPDF cảnh báo một số thao tác làm sạch ảnh có thể bỏ nội dung hoặc tạo lỗi hình, nên phải xem lại bản xuất. Bài kiểm trạng thái chữ ký PDF cũng nhắc cần phân biệt điều nhìn thấy với trạng thái kỹ thuật của tệp.
Thử lại cùng vùng sau mỗi thay đổi
So lại tiêu đề, dòng số và khối đã chọn bằng cùng phép kiểm. Thêm trang trước đó đúng để tránh cải thiện một trang nhưng làm xấu phần khác. Lưu kết quả từng vùng và phiên bản dẫn xuất. Không tuyên bố toàn bộ PDF đã chính xác chỉ từ ba vùng mẫu; phạm vi nghiệm thu phải tương ứng phạm vi đã kiểm.
Nếu không thể phục hồi đáng tin, người dùng cần biết phần nào chỉ được đọc thủ công hoặc cần bản nguồn mới. Tìm kiếm được vài từ không đủ để đưa số liệu sang bảng tính tự động. Đối với trường ảnh hưởng quyết định, chọn cách dừng có thể giải thích thay vì gán dữ liệu mặc định.
Kiểm vòng tìm kiếm với đúng từ khóa nghiệp vụ
Sau khi sửa bản dẫn xuất, thử tìm một mã hàng, một giá trị có dấu và một cụm có phủ định. Mở kết quả để xem vị trí tìm được có thật sự trùng vùng hiển thị. Từ được tìm thấy ở lớp chữ cũ có thể khiến hệ thống dẫn người dùng tới một trang không còn chứa nội dung đó bằng mắt.
Nếu tài liệu sẽ dùng cho hỏi đáp, lấy một câu trả lời dự kiến và kiểm vùng nguồn được trả lại. Đừng chỉ kiểm file TXT cuối cùng vì lỗi ánh xạ trang hoặc tọa độ có thể xuất hiện ở bước nhập kho. Câu trả lời và vị trí trích dẫn cần cùng chỉ về phiên bản tài liệu đã được nghiệm thu.
Tham khảo tài liệu gốc: OCRmyPDF. Sidecar không chứa toàn bộ chữ sẵn có; một số xử lý ảnh cần kiểm lại vì có thể mất nội dung. Các ví dụ, biểu mẫu và quyết định vận hành trong bài là đề xuất biên tập, không phải kết quả khách hàng.
Đầu ra tốt nhất là sổ lỗi kèm quyết định
Mỗi hàng ghi vùng, chữ nhìn thấy, chữ trích ra, loại sai khác, hướng xử lý và trạng thái xác nhận. Bản ghi này giúp người phụ trách lựa chọn giữa giữ lớp chữ, OCR lại một phần, phân tích bố cục hoặc xin tài liệu khác. Nó cũng giúp so sánh công cụ mà không dựa vào lời quảng cáo về độ chính xác chung.
Khi trao đổi xử lý tài liệu bằng AI, hãy đưa một PDF sai chữ có vùng đã đánh dấu và đầu ra đang bị ảnh hưởng. Mục tiêu là xác định đường lấy chữ có thể kiểm lại, trước khi nối vào quy trình trả lời hoặc nhập dữ liệu.
