
Hai tên tiếng Việt có thể nhìn giống nhau nhưng được mã hóa bằng các chuỗi khác nhau. Khi đối chiếu khách hàng hoặc tài liệu, cần tách vấn đề Unicode khỏi quyết định hai bản ghi có cùng một chủ thể hay không.
Một dấu hiển thị có thể có nhiều cách biểu diễn
Ký tự dựng sẵn và tổ hợp ký tự cơ sở với dấu kết hợp có thể cho cách hiển thị tương đương. So sánh từng byte có thể trả khác. NFC và NFD giải quyết dạng tương đương chuẩn tắc; các dạng tương thích có phạm vi biến đổi khác và không nên chọn chỉ vì tạo nhiều kết quả trùng hơn.
Giữ nguyên dữ liệu nguồn
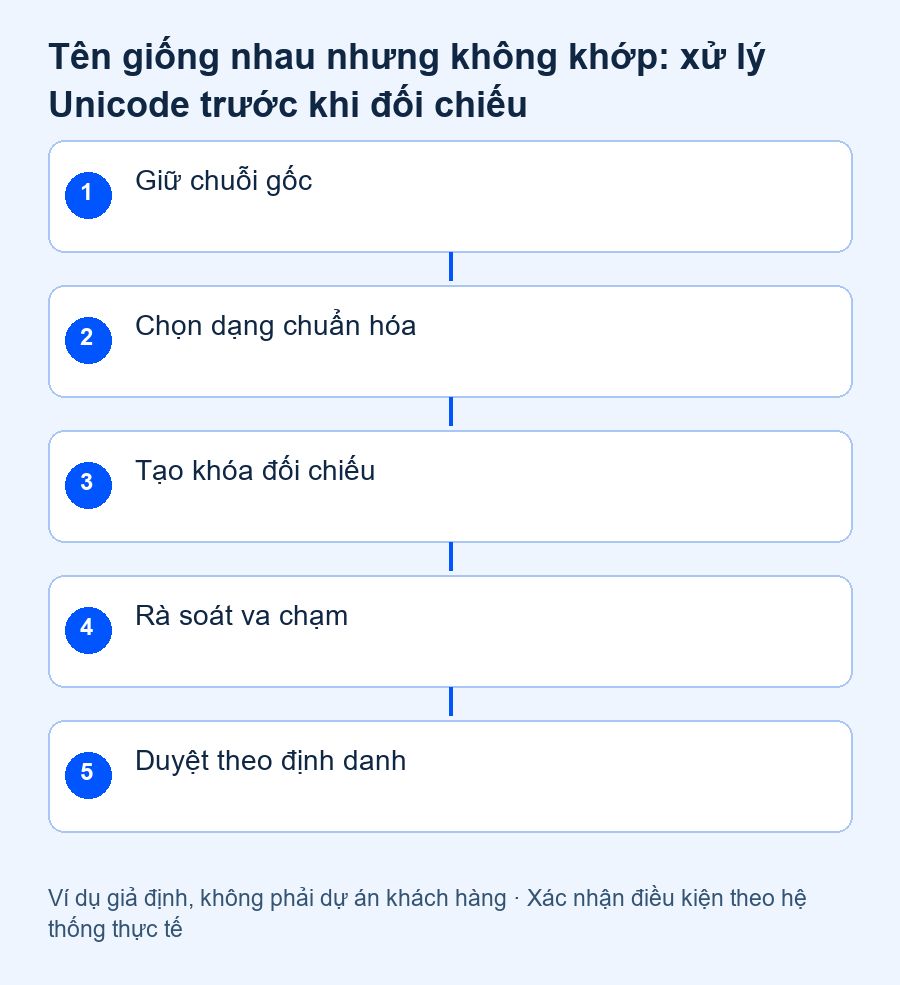
Lưu bản gốc để hiển thị và truy vết; tạo trường phục vụ đối chiếu theo quy tắc đã công bố. Ghi phiên bản quy tắc, dạng chuẩn hóa, cách xử lý khoảng trắng và hoa thường nếu có. Không trộn tất cả bước thành một hàm “làm sạch” mà không biết bước nào đã làm hai giá trị thành giống nhau.
Ví dụ giả định: hồ sơ doanh nghiệp từ hai nguồn
Một danh sách giả định có cùng tên doanh nghiệp được nhập từ bàn phím và sao chép từ tài liệu. Chuẩn hóa giúp phát hiện cặp đáng xem lại, nhưng mã số doanh nghiệp và địa chỉ mới là bằng chứng nghiệp vụ cần đối chiếu. Hai đơn vị cùng tên không được gộp chỉ vì khóa tên chuẩn hóa trùng.
| Trường | Mục đích | Quyết định |
|---|---|---|
| Tên hiển thị | Giữ cách viết nguồn | Không ghi đè âm thầm |
| Khóa tìm kiếm | Tìm gần đúng | Không dùng để tự merge |
| Định danh nghiệp vụ | Nhận diện chủ thể | Theo hợp đồng nguồn |
Bảng quyết định cho trường nhạy cảm
Tên hiển thị, mã sản phẩm và định danh đăng nhập có yêu cầu khác nhau. Bỏ dấu có thể hữu ích cho tìm kiếm nhưng làm mất khác biệt khi làm khóa duy nhất. Mã hàng có dấu gạch hoặc ký tự đặc biệt phải theo hợp đồng của nguồn; đừng tự sửa để bản import trông sạch hơn.
Nghiệm thu bằng cặp đối chiếu
Chuẩn bị cặp dựng sẵn–tổ hợp, khoảng trắng đầu cuối, chữ hoa thường và hai tên khác thật. Với mỗi cặp, ghi mong muốn trùng để tìm kiếm hay trùng để gộp. Kiểm tra cả lần chạy lại: quy tắc phải cho kết quả ổn định và giữ được giá trị nguồn khi cần phục hồi.
Chỉ gộp khi bằng chứng đủ
Danh sách va chạm là hàng chờ review, không phải lệnh merge. Chọn định danh đáng tin theo nghiệp vụ và ghi người duyệt. Điều này giúp tránh đổi một lỗi kỹ thuật về ký tự thành lỗi nghiêm trọng hơn về dữ liệu khách hàng.
Chuẩn bị gì khi trao đổi phạm vi triển khai?
Chọn vài cặp chuỗi giả lập và tiêu chí trùng thật trước khi bàn chuẩn hóa dữ liệu trong phần mềm. Người sở hữu dữ liệu cần chốt trường nào dùng tìm kiếm, trường nào được dùng nhận diện; việc gộp bản ghi là quyết định riêng.
Nguồn kiểm chứng và giới hạn áp dụng
Tài liệu chính thức: Unicode UAX15 định nghĩa các dạng chuẩn hóa. Đối chiếu ngày 12/10/2026. Các bảng và quy trình trong bài là đề xuất biên tập; ví dụ giả định không phải dự án hay kết quả khách hàng Onter.
