
Một bản demo trả lời tốt mười câu quen thuộc chưa cho biết AI sẽ xử lý thế nào khi hồ sơ thiếu hoặc yêu cầu nằm ngoài phạm vi. Bộ mẫu đánh giá cần phản ánh các loại việc thật, có đáp án hoặc tiêu chí duyệt độc lập và có nhóm kiểm tra việc biết dừng.
Bắt đầu từ quyết định mà kết quả AI sẽ ảnh hưởng
Liệt kê các công việc người dùng giao, hậu quả nếu sai và thông tin bắt buộc để xử lý. Mẫu có thể được xây từ tình huống đã ẩn dữ liệu theo quyền truy cập hoặc tình huống mô phỏng ghi rõ; không thu thập dữ liệu nhạy cảm chỉ để đủ số lượng. Tài liệu đánh giá của OpenAI khuyến nghị bài đánh giá theo nhiệm vụ và trường hợp biên. Đây là hướng dẫn thiết kế thử nghiệm, không phải bằng chứng một hệ thống cụ thể đạt chất lượng.
Chia nhóm trước khi tính điểm
Tối thiểu phân biệt ca thường, ca có ngoại lệ, ca thiếu dữ liệu, ca mâu thuẫn và yêu cầu ngoài phạm vi. Trọng số nghiệp vụ phải được chủ quy trình chấp nhận; không tự lấy tỷ trọng từ phỏng đoán. Báo số mẫu và kết quả từng nhóm bên cạnh tổng thể. Một nhóm có ít mẫu cần ghi giới hạn thay vì dùng phần trăm đẹp. Nếu một lỗi có hậu quả lớn, đặt tiêu chí chặn riêng; điểm trung bình không được xóa lỗi đó.
Ví dụ mô phỏng: trợ lý tìm chính sách nội bộ
Bộ mẫu thử có câu hỏi rõ trong tài liệu hiện hành, câu có hai chính sách trái nhau, câu thiếu ngày áp dụng và câu yêu cầu thông tin không có quyền xem. Với câu thiếu ngày, kết quả tốt có thể là hỏi lại, không phải cố trả lời. Với thông tin bị hạn chế, đánh giá việc từ chối hoặc chuyển đúng người theo thiết kế đã duyệt. Các tình huống mô phỏng không chứng minh khả năng bảo mật thật; quyền truy cập vẫn phải được kiểm tra riêng.
Giữ một phần mẫu chưa dùng để sửa hệ thống
Nếu liên tục sửa prompt theo chính bộ câu nghiệm thu, kết quả tăng có thể chỉ phản ánh việc quen mẫu. Tách bộ phát triển và bộ đánh giá khóa; ghi phiên bản, người tạo đáp án và điều kiện chạy. Khi lỗi mới xuất hiện ngoài thực tế, bổ sung vào bộ hồi quy nhưng giữ lịch sử để giải thích kết quả qua các lần. Không kết luận hiệu quả vận hành hoặc ROI từ điểm đánh giá. Nghiệm thu nên mô tả hệ thống nào, dữ liệu nào và phạm vi nào đã được thử.
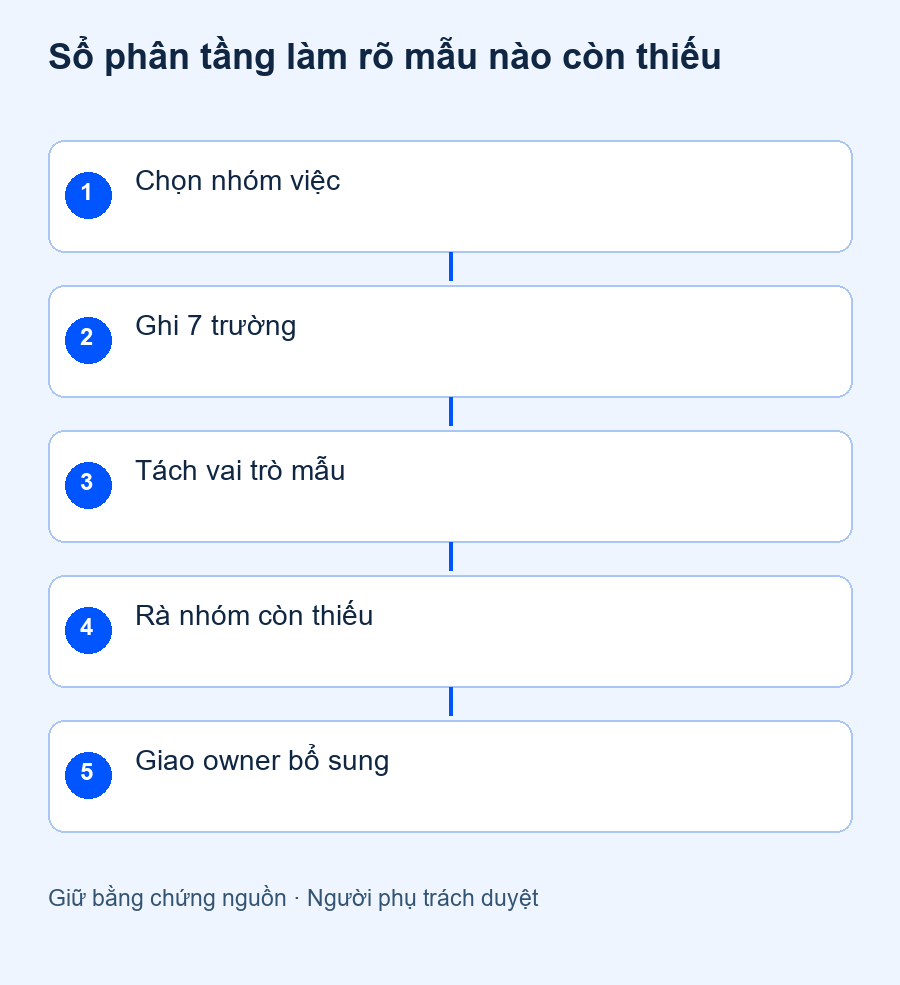
Sổ mẫu phân tầng: mỗi ca thử phải có một vai trò rõ
Lập một sổ mẫu trước khi chạy: case_id để truy lại ca thử; stratum để biết nhóm tình huống; risk để ghi hậu quả nghiệp vụ nếu sai; source_provenance để phân biệt dữ liệu được phép với mô phỏng; set_role để tách mẫu phát triển và mẫu khóa; owner để xác nhận đáp án; expected_action để ghi hành động chấp nhận được. Không dùng tên file hoặc số thứ tự thay cho cả bảy thông tin.
| case_id | Nhóm / vai trò | Nguồn / owner | Hành động kỳ vọng |
|---|---|---|---|
| SIM-01 | Thiếu ngày / mẫu khóa | Mô phỏng / owner chính sách | Hỏi ngày áp dụng, chưa kết luận |
| SIM-02 | Mâu thuẫn / mẫu phát triển | Mô phỏng / owner chính sách | Nêu hai nguồn xung đột để duyệt |
Hai dòng trên là mô phỏng cách ghi, không phải kết quả thử. Khi báo độ phủ, liệt kê nhóm nào có mẫu, số mẫu hợp lệ và nhóm nào còn thiếu; không gọi việc có hai ca thử là đại diện thống kê hoặc độ tin cậy của hệ thống. Nếu chưa có ca về phạm vi chi nhánh, ghi khoảng trống đó và giao owner bổ sung. Mục đích của sổ là ngăn bộ thử chỉ chứa những ví dụ dễ, không thay thế toàn bộ quy trình nghiệm thu.
Bảng làm việc để áp dụng
| Nhóm mẫu | Điều cần quan sát | Kết quả có thể đúng |
|---|---|---|
| Thường gặp | Trả lời đúng nguồn | Đáp án có dẫn nguồn |
| Thiếu dữ liệu | Biết hỏi lại | Yêu cầu trường còn thiếu |
| Mâu thuẫn | Không chọn tùy tiện | Nêu xung đột để duyệt |
| Ngoài phạm vi | Biết giới hạn | Từ chối hoặc chuyển người |
| Hậu quả cao | Không bỏ qua gate | Dừng thao tác rủi ro |
Trước khi đưa kết quả vào công việc
- Có tiêu chí duyệt trước khi chạy.
- Báo kết quả từng nhóm và số mẫu.
- Tách mẫu phát triển và mẫu khóa.
- Không suy ROI hoặc an toàn production từ điểm trung bình.
Nghiệm thu có ích khi chỉ ra hệ thống được phép làm gì và phải dừng ở đâu. Một kết quả biết hỏi lại đúng lúc có thể phù hợp nghiệp vụ hơn một câu trả lời trôi chảy nhưng thiếu căn cứ.
Trước một buổi demo tiếp theo, hãy đưa cả ca thiếu dữ liệu và ca phải dừng vào danh sách câu hỏi. Liên kết bộ mẫu với tiêu chí nghiệm thu AI Agent để người mua, chủ quy trình và đơn vị triển khai cùng hiểu kết quả nào được chấp nhận, kết quả nào cần thử thêm.
Nguồn và giới hạn
Tham khảo
Evaluation best practices (đọc ngày 12/10/2026). Các bảng và ví dụ trong bài là hướng dẫn biên tập hoặc mô phỏng, không phải số liệu khách hàng hay kết quả triển khai. Tính năng cụ thể phụ thuộc công cụ, cấu hình và quyền sử dụng thực tế.
