
Một dịch vụ chưa nhận được việc không nhất thiết cần khởi động lại. Nếu mỗi lần phụ thuộc chậm đều kích hoạt restart, ứng dụng có thể mất thêm thời gian khởi động mà vẫn gặp cùng phụ thuộc. Liveness và readiness nên trả lời hai câu hỏi khác nhau; startup lại bảo vệ giai đoạn ban đầu.
Chọn hành động trước khi chọn URL kiểm
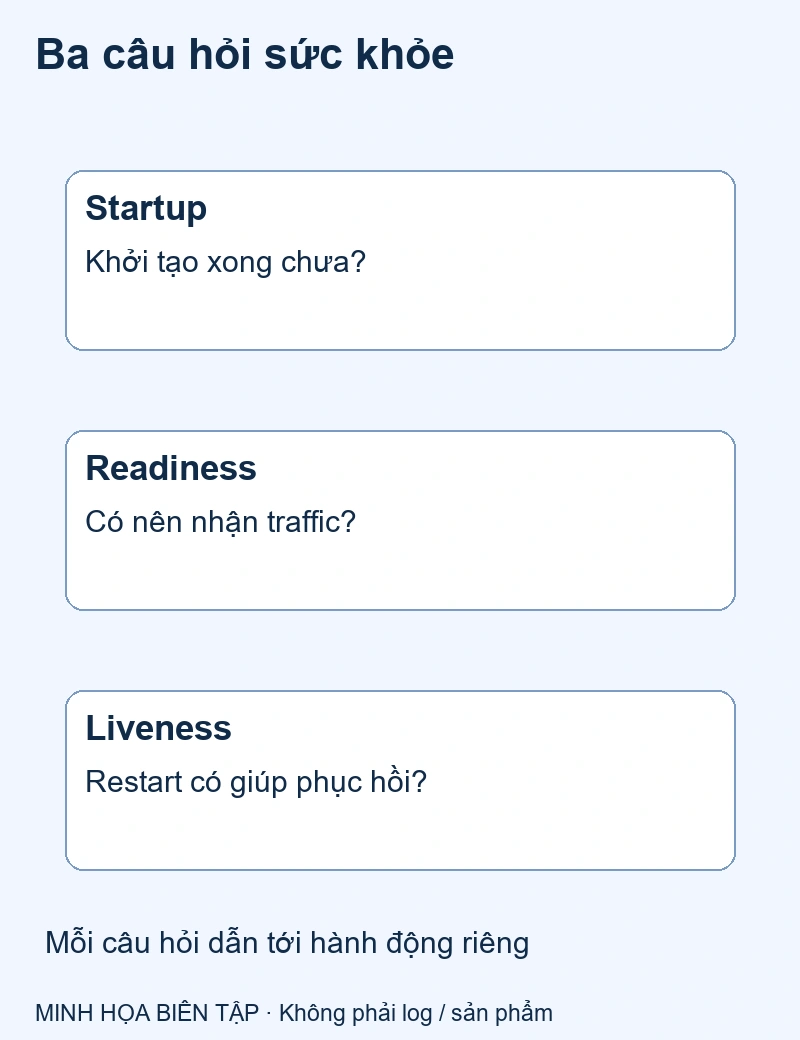
Liveness giúp quyết định tiến trình có cần bị khởi động lại theo chính sách nền tảng không. Readiness giúp quyết định có đưa traffic tới instance này không. Startup cho phép ứng dụng hoàn tất khởi tạo trước khi các phép kiểm khác có hiệu lực theo cấu hình. Nếu chưa biết hành động mong muốn, một endpoint health trả chung “OK” hoặc “FAIL” rất dễ bị dùng sai.
Kubernetes hướng dẫn các loại probe và việc Pod không ready không nhận traffic qua Services. Điều này không tự dừng nguồn job ngoài Kubernetes Service. Với nền tảng khác, hành động restart/routing phải đọc theo cơ chế cụ thể, không sao chép nguyên tên probe rồi suy rằng hành vi giống nhau.
Một phụ thuộc chậm đặt ra câu hỏi về khả năng phục vụ
Ví dụ giả định: tiến trình web vẫn xử lý được request tĩnh nhưng một đường ghi cần cơ sở dữ liệu đang lỗi. Owner phải quyết định instance còn có thể phục vụ gì, lỗi trả ra sao và có nên ngừng route toàn instance không. Không có một quy tắc “mọi dependency phải khỏe” đúng cho mọi endpoint.
Nếu liveness gọi tất cả dịch vụ bên ngoài, một sự cố phụ thuộc có thể khiến toàn bộ instance restart lặp. Restart không sửa dịch vụ bên ngoài và có thể làm giảm khả dụng thêm. Ngược lại, liveness luôn trả thành công mà không phản ánh khả năng tiến triển của tiến trình cũng không giúp phát hiện một số trạng thái treo. Cần lựa chọn tín hiệu có ý nghĩa, chi phí thấp và được kiểm.
Ma trận tình huống thay một cờ health chung
| Tình huống giả định | Câu hỏi | Hành động cần thống nhất |
|---|---|---|
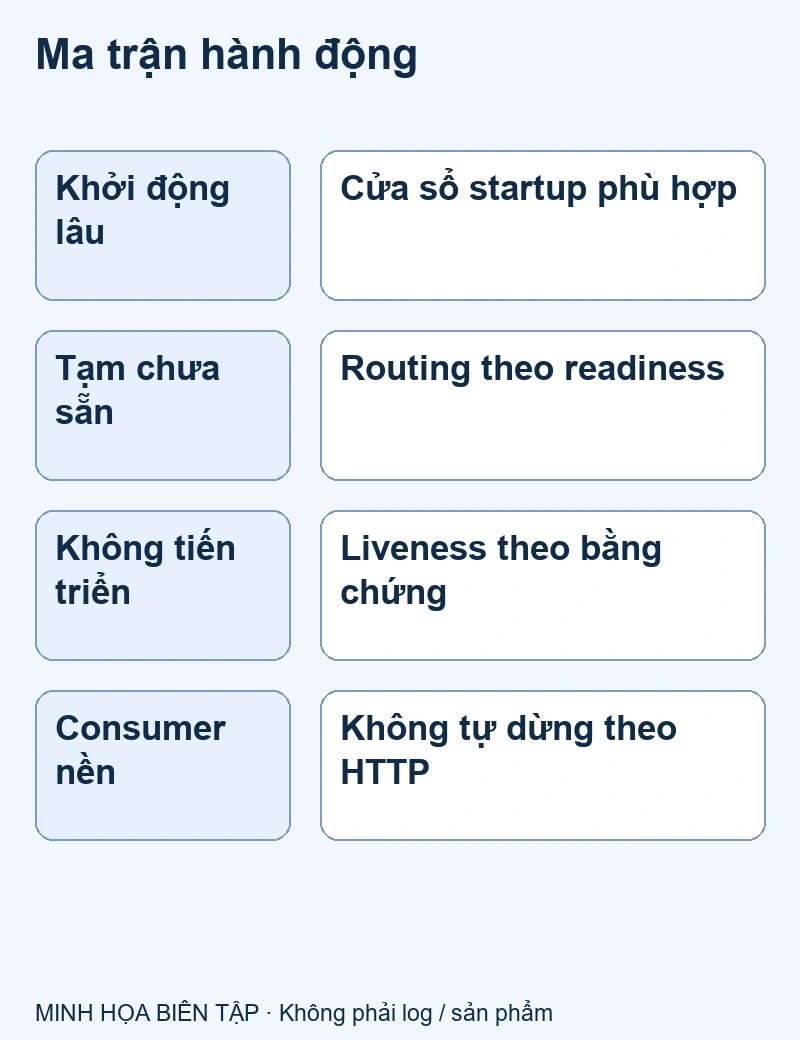
| Đang tải cấu hình ban đầu | Startup hoàn tất chưa? | Cho cửa sổ khởi động phù hợp |
| Tạm quá tải | Có nên nhận thêm traffic? | Readiness/routing theo thiết kế |
| Tiến trình không tiến triển | Restart có giúp phục hồi? | Liveness theo bằng chứng |
| Đang deploy/drain | Ngừng nguồn nhận việc nào? | Phân biệt HTTP với consumer nền |
Bảng là đề xuất biên tập, không phải cấu hình đã triển khai. Tên tình huống phải gắn với tín hiệu thực: đo được quá tải bằng gì, “không tiến triển” nghĩa gì và owner nào duyệt. Không thêm truy vấn nặng hoặc thao tác ghi vào health check chỉ để làm nó giống nghiệp vụ.
Ngưỡng và thời gian cần xét cùng nhau
Period, timeout, số lần lỗi trước hành động và cửa sổ startup cùng ảnh hưởng tới thời gian phát hiện. Ngưỡng quá nhạy có thể tạo restart hoặc route flapping; quá rộng có thể kéo dài sự cố. Cần chọn từ đặc tính ứng dụng và bằng chứng thử, không có một bộ số mặc định đảm bảo phù hợp mọi hệ thống.
Readiness phục hồi cũng cần được xem. Một instance vừa báo ready có thực sự đủ cấu hình, kết nối và tài nguyên để nhận traffic hay không? Nếu chỉ chuyển cờ sau một lệnh ping, đường nghiệp vụ có thể vẫn lỗi. Nhưng mở rộng check sang mọi tác vụ lại tăng chi phí và phụ thuộc. Đó là bài toán chọn tín hiệu tối thiểu đủ đại diện, không phải càng nhiều phép kiểm càng tốt.
Đừng tiết lộ cấu hình qua health endpoint
Thông báo công khai chỉ cần mức trạng thái phù hợp. Chi tiết dependency, credential hoặc thông tin nội bộ nên ở kênh quan sát có quyền. Nếu dùng endpoint sâu cho vận hành, phải có kiểm soát truy cập và giới hạn; không biến nó thành cổng truy vấn hệ thống không xác thực.
Health check cũng có thể gặp lỗi mạng hoặc chậm do chính đường quan sát. Khi một probe báo fail, giữ thời điểm, loại lỗi và tình trạng ứng dụng để phân tích. Đừng tự chuyển mọi lỗi quan sát thành kết luận “ứng dụng treo”.
Bộ nghiệm thu tập trung vào hành động
Trong môi trường được phép, chuẩn bị khởi động chậm, phụ thuộc tạm lỗi, quá tải và tiến trình mất khả năng tiến triển theo cơ chế có kiểm soát. Quan sát traffic được route thế nào, có restart không và người dùng nhận trạng thái nào. Một response200 của health endpoint không phải bằng chứng quy trình phục hồi đạt.
Circuit breaker bảo vệ lời gọi phụ thuộc, khác quyết định sống/sẵn sàng của instance. Nghiệm thu tải cung cấp bối cảnh khi chọn tín hiệu quá tải. Để khảo sát phần mềm với Onter, hãy mô tả ba tình huống cần hành động khác nhau; không cần khởi động lại production hay thay cấu hình hạ tầng chỉ để chuẩn bị cuộc trao đổi.
