
RAM tăng sau vài giờ chạy không đủ để kết luận rò rỉ bộ nhớ. Worker có thể đang giữ nhiều việc hơn, Buffer lớn hơn hoặc một tập đối tượng không được giải phóng. Worker tăng RAM cần được xem cùng lượng công việc, vùng bộ nhớ và phiên bản phần mềm.
Bắt đầu bằng thước đo đang nhìn
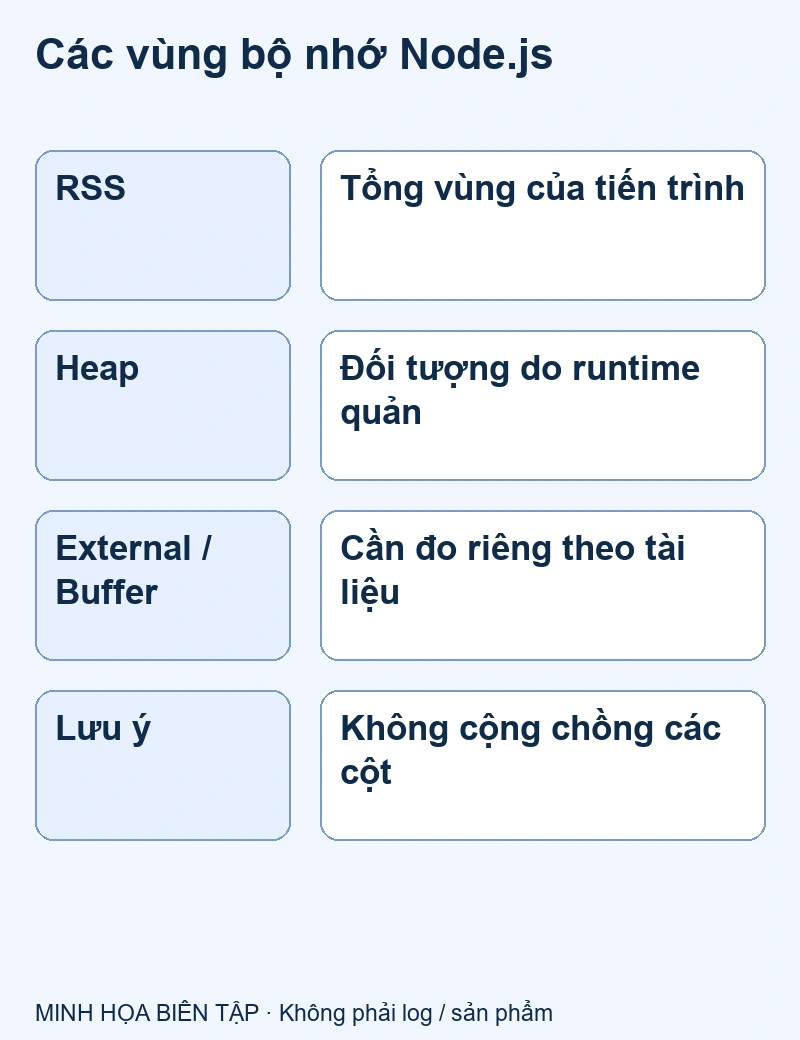
Giới hạn container, RSS của tiến trình và heap của runtime không phải một con số. Theo tài liệu bộ nhớ Node.js, process.memoryUsage() phân biệt RSS, heapTotal, heapUsed, external và arrayBuffers. Một mức heap ổn định không đủ chứng minh toàn bộ tiến trình ổn định.
RSS bao gồm nhiều vùng, nên không cộng RSS với heapUsed để tạo “tổng bộ nhớ” mới. External và Buffer cũng cần hiểu theo tài liệu runtime trước khi cộng các cột có phần giao nhau. Sổ metric nên ghi đơn vị, tên trường, nguồn và cách lấy mẫu; khi đổi phiên bản công cụ, giữ sự khác biệt đó để tránh so hai thước đo khác nhau.
Đặt lượng việc và bộ nhớ trên cùng cửa sổ
Ghi số job đang xử lý, số job đã lấy nhưng chưa bắt đầu, kích thước đầu vào theo nhóm và mức song song. Một worker đọc trước rất nhiều message có thể giữ dữ liệu trong RAM dù chỉ xử lý vài job. Hàng đợi ở broker giảm không có nghĩa lượng việc trong toàn hệ thống giảm: nó có thể chuyển vào bộ nhớ của consumer.
Không cần đưa payload riêng hoặc customer ID vào metric để có bối cảnh. Nhóm kích thước, loại tác vụ và phiên bản worker thường đủ cho bước điều tra ban đầu. Chi tiết định danh cần kênh log có quyền, đúng mục đích. Chính metric không được trở thành nguồn tăng tài nguyên không kiểm soát.
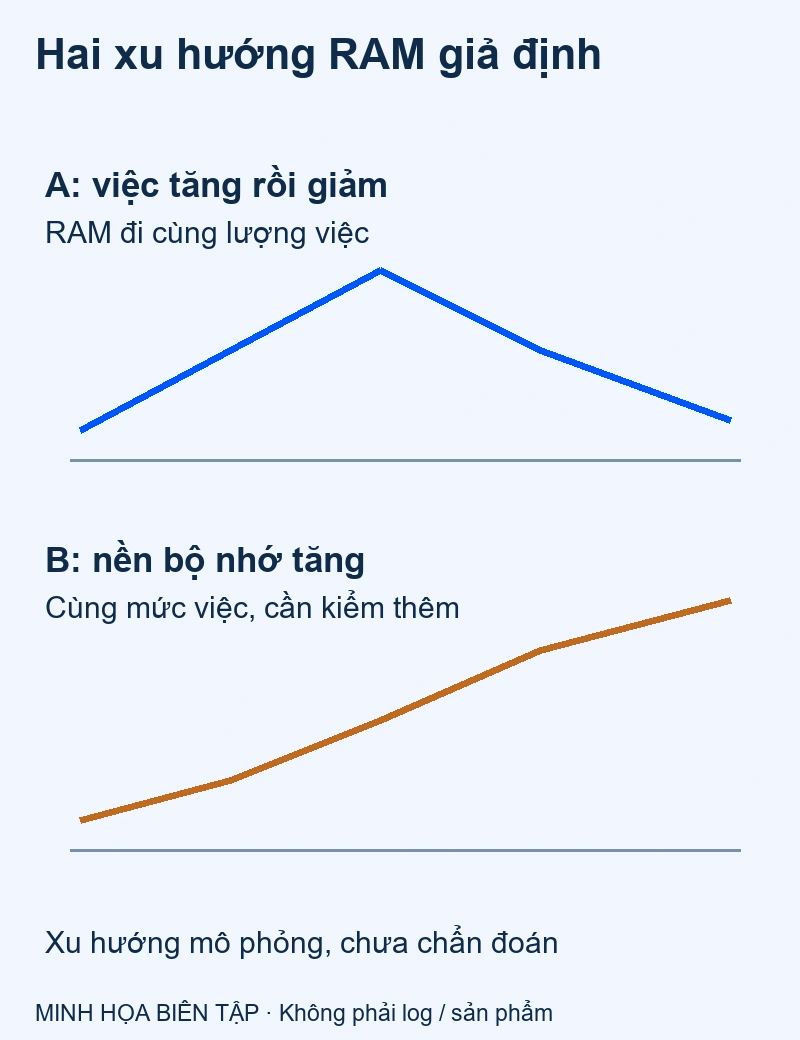
Hai xu hướng mô phỏng dẫn đến hai giả thuyết khác nhau
Ca A giả định: lượng job đang giữ tăng rồi giảm, bộ nhớ tăng rồi trở về vùng nền gần trước. Ca B: cùng mức việc, sau mỗi chu kỳ nền heapUsed vẫn cao hơn. A gợi ý áp lực do lượng việc; B đáng kiểm đối tượng bị giữ. Cả hai chỉ là dấu hiệu, chưa phải chẩn đoán cuối từ một biểu đồ.
| Quan sát | Cần kiểm thêm |
|---|---|
| RSS tăng, heap ổn định | Buffer, thư viện native, vùng ngoài heap |
| Heap nền tăng qua nhiều chu kỳ | Đối tượng giữ lại và vòng đời tham chiếu |
| RAM đi cùng lượng job đã lấy | Prefetch, song song, kích thước dữ liệu |
| Chỉ tăng ở phiên bản mới | Thay đổi code, cấu hình và loại tải |
Đường trên hình là dữ liệu tổng hợp do biên tập tạo để giải thích, không phải benchmark, log production hoặc kết quả tiết kiệm RAM của Onter. Không chọn một ngưỡng từ đường giả định làm cảnh báo thật.
Giảm dữ liệu còn giữ trước khi tăng heap
Kiểm cache không giới hạn, mảng gom kết quả, listener hoặc timer sống quá lâu và dữ liệu gắn vào đối tượng toàn cục. Với file lớn, xem ứng dụng có nạp tất cả rồi mới xử lý hay không; streaming có thể phù hợp nhưng phải giữ khả năng kiểm lỗi, thứ tự và kết quả theo yêu cầu.
Giảm mức song song là một giả thuyết cần thử, không phải thuốc chung. Nếu tốc độ xử lý giảm quá nhiều, tuổi job chờ có thể xấu đi. Cần so RAM, thời gian hoàn tất và số việc còn chờ cùng lúc; một biểu đồ RAM thấp hơn không chứng minh trải nghiệm tốt hơn.
Heap dump có ích nhưng không phải file chia sẻ thông thường
Dump hoặc snapshot có thể chứa token, dữ liệu người dùng và nội dung tài liệu đang xử lý. Chỉ thu khi có quyền, biết tác động lên tiến trình và nơi lưu đủ an toàn. Không gửi nguyên dump qua chat hoặc form tư vấn. Cần chính sách giữ/xóa và người được đọc như một loại dữ liệu nhạy cảm.
Khi có công cụ phân tích phù hợp, mục tiêu là xác định loại đối tượng còn được tham chiếu, đường giữ và thay đổi qua các mốc tương đương. Không ép garbage collection trên production chỉ để làm ảnh biểu đồ đẹp. Những thay đổi runtime phải được thử có phạm vi và rollback, tách khỏi việc quan sát.
Viết kết luận theo mức bằng chứng
Một kết luận tốt có thể là “RAM tăng cùng lượng job giữ trong worker; chưa chứng minh leak” hoặc “snapshot được phép cho thấy collection X giữ dữ liệu qua nhiều chu kỳ”. Ghi điều chưa biết và bước kiểm tiếp. Restart định kỳ có thể là biện pháp tạm được duyệt nhưng không được báo thành đã sửa nguyên nhân.
Tham khảo miền label của metric để quan sát không tạo thêm chi phí không cần thiết. Nghiệm thu tải theo bài toán và phân vị giúp so cả độ trễ khi thay mức song song. Khi bàn phạm vi phần mềm với Onter, chuỗi số liệu đã che dữ liệu và bản đồ vòng đời job là điểm bắt đầu; chưa cần gửi dump hoặc cấp quyền vào production.
